AI 难实现
把复杂度包进组件
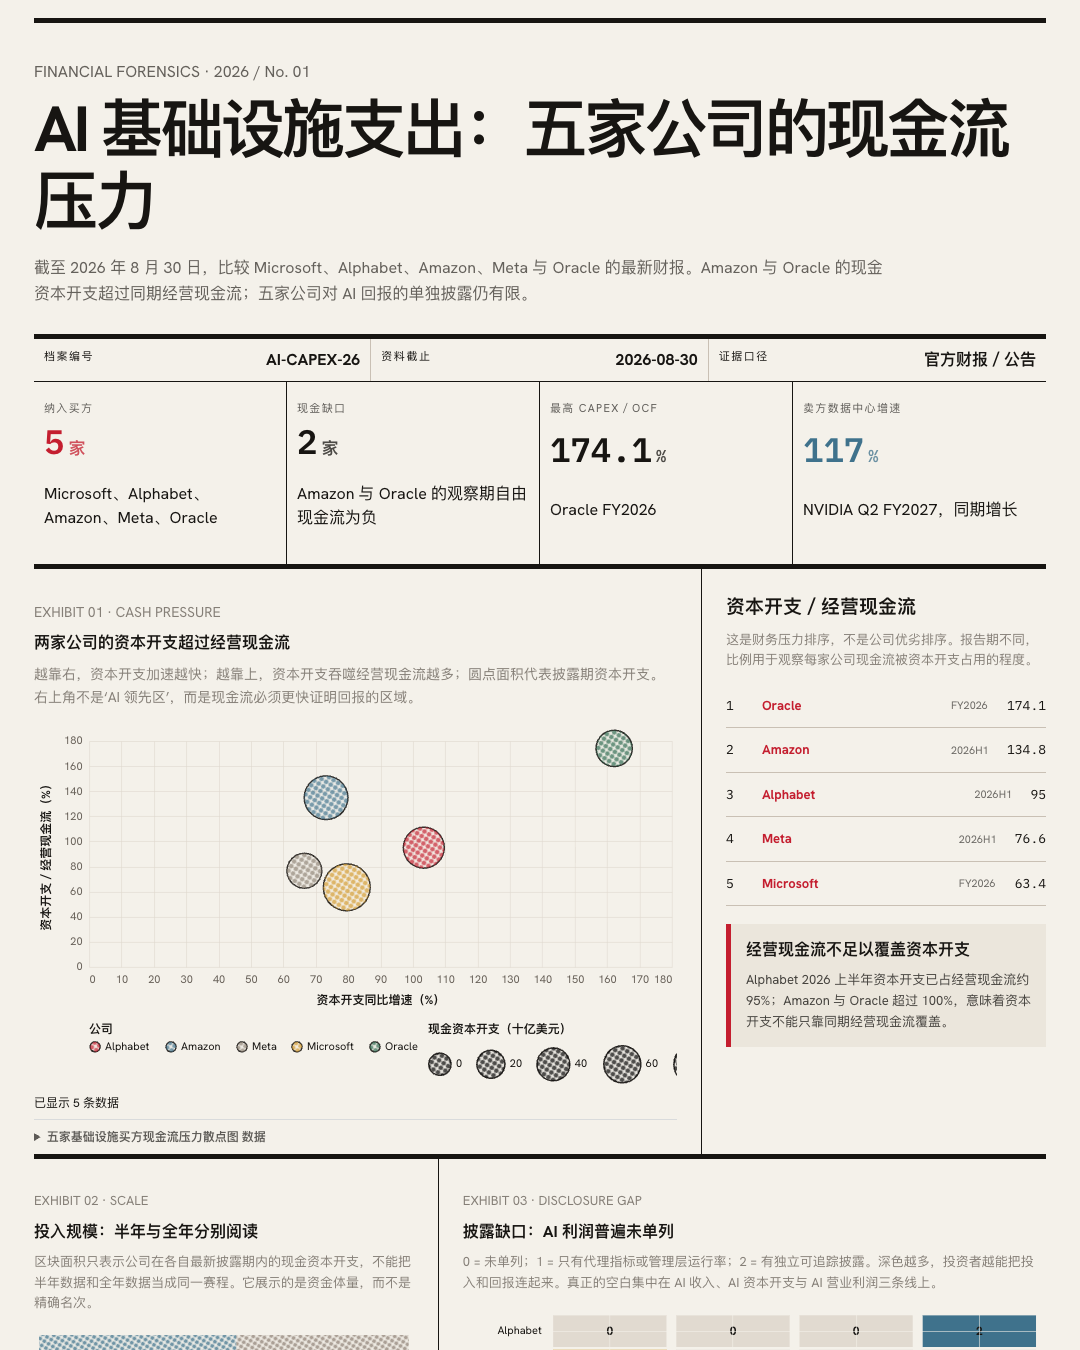
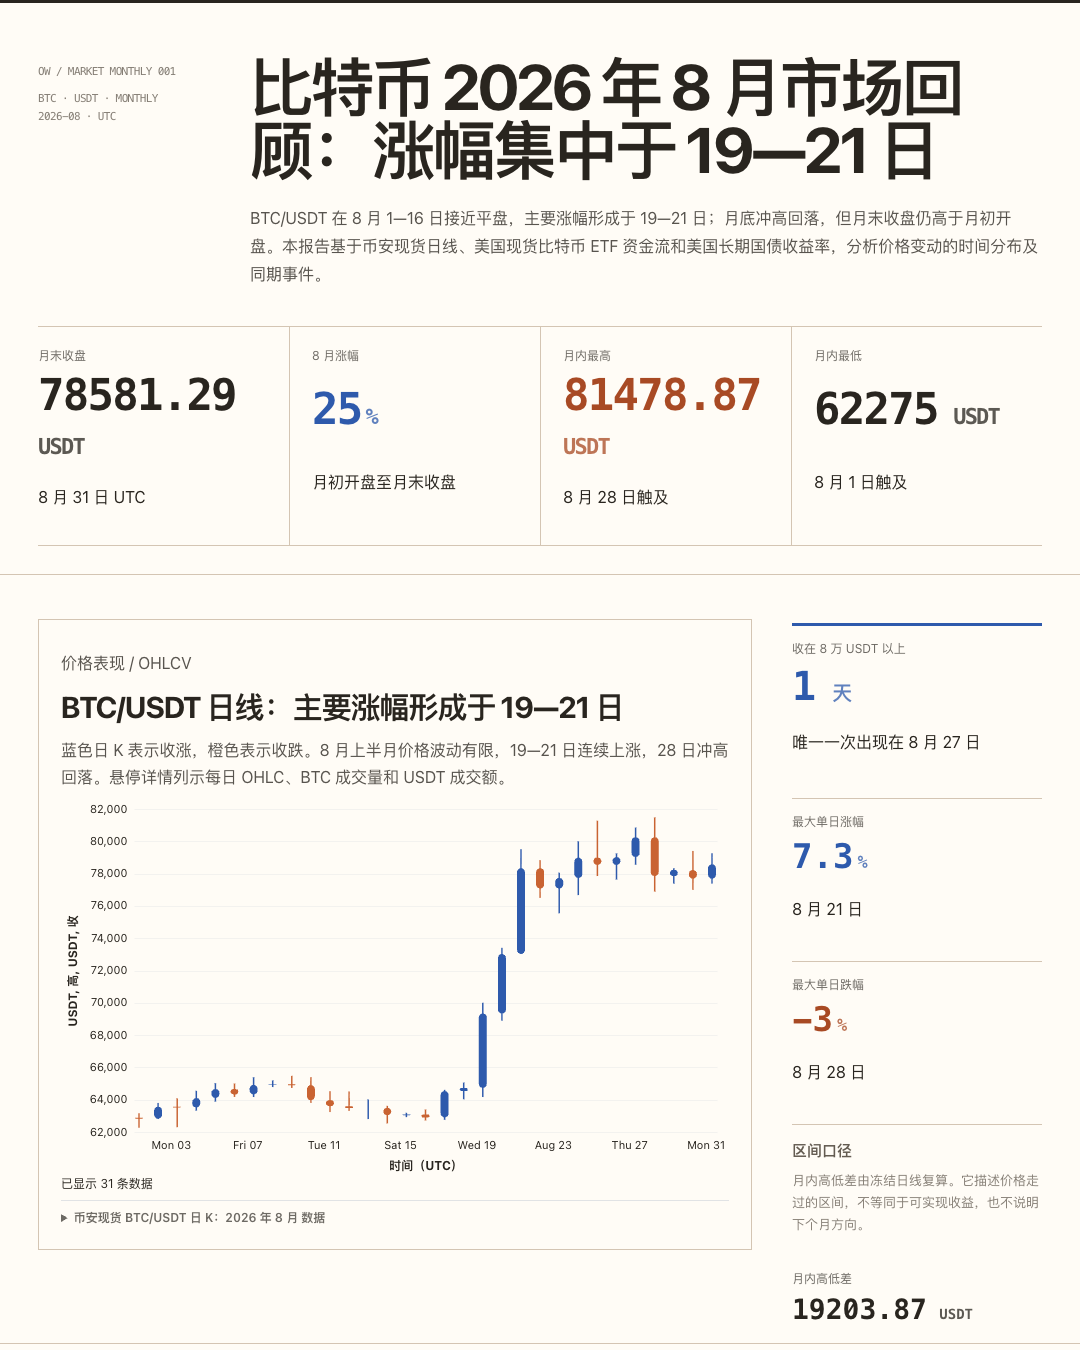
高级图表、空间布局和联动效果,被封装成经过验证的组件,只暴露少量有意义的参数。
简单调参 → 高级、稳定的效果从内容组合到实际渲染,了解 OWL Compose 怎样帮助 AI 完成文档,以及我们如何验证效果。
方案对比
直接生成快,但效果看模型发挥;套模板更稳,但能做的有限。OWL Compose 既能让 AI 自由组合,也能把作品稳定地做完,之后还可以继续改。
出结果快,但每次效果都看模型发挥。
上手快、结果稳,但内容和版式受模板限制。
既能自由组合版式、图表和视觉,也能持续修改和发布。
直接生成更快、更自由;套模板更容易上手、结果更稳;OWL Compose 在完整创作流程上更均衡。
持续实验
我们持续用价格–性能前沿的基准模型测试 OWL Compose。固定任务、固定配置,发现问题就改;模型升级后,再重新验证和调整,让新能力真正用到作品里。
自适应抽象
作者语法不会一刀切地做粗或做细。我们依据基准模型能否稳定完成,来决定每一层的边界。
高级图表、空间布局和联动效果,被封装成经过验证的组件,只暴露少量有意义的参数。
简单调参 → 高级、稳定的效果当模型已能稳定组合,我们就把能力拆成更细的原子语法,而不是锁进模板。
细粒度语法 → 更高的创作自由用相同的基准模型和固定任务,我们经常对每层能力做消融实验。只有证据说明有帮助的边界才会保留。
15 个模型配置 · AA 指数 v4.2 · 美元 / 指数任务
彩色点连成对数成本轴上的上包络。灰点有更便宜且同等或更强的替代;空心点虽未被直接替代,增益仍低于包络。这是有来源的模型样本,并非完整榜单。前沿点只进入作品质量实测候选,不代表已通过;缺少任务成本的模型不纳入。
| Model | USD | AA v4.2 | 价格–性能前沿 |
|---|---|---|---|
| GPT-5.6 Luna (max) | 0.10 | 43 | 基准候选 |
| GLM-5.3-Flash | 0.18 | 46 | 基准候选 |
| DeepSeek V4 Flash 0731 (max) | 0.14 | 41 | 被更优模型替代 |
| MiniMax-M3 | 0.23 | 36 | 被更优模型替代 |
| DeepSeek V4 Pro 0813 (max) | 0.33 | 42 | 被更优模型替代 |
| Gemini 3.1 Pro Preview | 0.34 | 37 | 被更优模型替代 |
| Gemini 3.7 Flash (high) | 0.55 | 45 | 被更优模型替代 |
| GPT-5.6 Terra (max) | 0.81 | 47 | 低于性价比包络 |
| Muse Spark 1.3 (max) | 0.96 | 53 | 基准候选 |
| GPT-5.6 Sol (max) | 1.25 | 51 | 被更优模型替代 |
| GLM-5.3 (max) | 1.26 | 49 | 被更优模型替代 |
| Kimi K3 (max) | 1.58 | 50 | 被更优模型替代 |
| GPT-6 Astra (max) | 2.57 | 55 | 低于性价比包络 |
| Claude Opus 5 (max) | 4.21 | 54 | 被更优模型替代 |
| Claude Fable 5.1 (max, fallback) | 6.12 | 57 | 基准候选 |